En fin de mois, une responsable administrative prépare le reporting destiné à la direction de son entreprise.
Elle commence par exporter les factures depuis l’ERP. Elle récupère ensuite les encaissements dans un fichier distinct, ouvre le budget prévisionnel, puis consulte un tableau transmis par le service commercial. Les données doivent être rapprochées : les périodes ne correspondent pas toujours, certaines catégories ont changé et quelques références nécessitent une vérification.
Une formule Excel ne couvre plus toutes les lignes du nouvel export. Une facture annulée apparaît encore dans les ventes. Les graphiques doivent être actualisés, les écarts recalculés et les commentaires intégrés à une présentation.
Après plusieurs contrôles, le document est finalement exporté en PDF et envoyé à la direction.
Le mois suivant, presque tout recommence.
Cette situation peut concerner une PME à Antananarivo, une entreprise de distribution, une organisation multisite ou une ONG qui consolide périodiquement ses activités. Elle n’a rien de spécifiquement malgache : partout, des équipes consacrent encore une part importante de leur travail à reconstruire des rapports dont les règles et les sources changent relativement peu.
Le problème n’est pas nécessairement Excel. Il n’est pas non plus lié à l’existence d’un reporting mensuel.
Il tient à une question plus fondamentale : combien de temps est consacré à comprendre l’activité, et combien simplement à reconstruire les chiffres qui permettront ensuite de l’analyser ?
C’est précisément cette frontière que le reporting automatisé cherche à déplacer.
Produire un rapport et analyser ses résultats : deux métiers différents
Le reporting consiste à produire, selon une fréquence déterminée, une représentation structurée de l’activité : ventes, trésorerie, dépenses, stocks, avancement des projets ou indicateurs de performance.
L’analyse commence lorsque ces informations sont utilisées pour comprendre une évolution, expliquer un écart, identifier une anomalie ou préparer une décision.
Ces deux activités sont complémentaires, mais elles ne mobilisent pas les mêmes compétences.
Extraire des fichiers, harmoniser des formats, recopier des formules et actualiser des graphiques relèvent principalement de la production du rapport. Comprendre pourquoi la marge diminue, pourquoi les créances augmentent ou pourquoi un site atteint moins bien ses objectifs relève de l’analyse.
Le reporting devrait mobiliser du temps pour comprendre les chiffres, pas principalement pour les reconstruire.
L’automatisation du reporting désigne l’organisation d’un processus capable de récupérer, transformer, contrôler, consolider et restituer les données de manière répétable, avec moins d’interventions manuelles.
Cela ne signifie ni supprimer les vérifications humaines ni construire systématiquement un tableau de bord en temps réel.
Un rapport mensuel peut rester mensuel tout en bénéficiant d’une production largement automatisée.
Pourquoi le reporting manuel fonctionne… jusqu’à un certain point
Un classeur Excel peut parfaitement répondre aux besoins d’une petite organisation : une source de données, quelques indicateurs, un responsable identifié et un rapport produit occasionnellement.
Dans cette situation, construire une architecture automatisée complexe pourrait coûter davantage que ce qu’elle apporterait.
Les difficultés apparaissent généralement avec la croissance du processus.
Les sources se multiplient. Le service commercial utilise un CRM, la comptabilité un ERP, les responsables terrain des fichiers distincts. Plusieurs personnes interviennent dans la préparation des données. De nouvelles catégories ou règles de calcul apparaissent.
Le reporting devient alors une succession d'opérations interdépendantes.
La personne qui produit le rapport doit connaître les particularités de chaque source, les exceptions à appliquer et l’ordre précis des manipulations.
Le processus fonctionne encore, mais sa reproductibilité devient fragile.
L’automatisation n’est donc pas une opposition entre Excel et les outils modernes. Elle répond d’abord à une augmentation de la complexité et de la répétition.
Excel peut continuer à servir aux budgets, simulations, analyses ponctuelles et contrôles. Il n’a simplement pas vocation à rester, dans tous les contextes, l’orchestrateur manuel de l’ensemble du reporting.
Le coût invisible du copier-coller
Un copier-coller prend quelques secondes. Un export peut être réalisé rapidement. Modifier une formule semble anodin.
Mais ces gestes ne constituent qu’une partie du travail.
À chaque échéance, il faut parfois retrouver les bons fichiers, vérifier les périodes, harmoniser les colonnes, rapprocher les références, corriger les anomalies, contrôler les résultats, actualiser la présentation et distribuer la version définitive.
Pris isolément, chaque geste paraît raisonnable.
Répétés chaque semaine ou chaque mois, ils constituent une véritable charge de production.
À cette charge directe s’ajoutent des coûts moins visibles : retard de disponibilité des indicateurs, dépendance à une personne, difficulté à reproduire les chiffres d’une période antérieure et temps consacré à expliquer des écarts entre versions.
Le coût réel du reporting manuel ne se résume donc pas au nombre d’heures passées devant Excel.
Il comprend aussi le délai entre le moment où les données existent et celui où elles deviennent réellement utilisables pour décider.
Quand les manipulations deviennent des risques
Les erreurs les plus problématiques ne sont pas toujours spectaculaires.
Une formule peut continuer à fonctionner tout en utilisant une plage incomplète. Un nouvel export peut contenir des lignes supplémentaires qui ne sont pas intégrées. Un filtre peut conserver le mois précédent. Une facture peut être comptabilisée deux fois lors du rapprochement de deux sources.
Un changement de format de date ou de séparateur décimal peut également perturber les calculs. Une correction réalisée dans un fichier peut ne pas avoir été reportée dans sa copie.
Ces anomalies ont un point commun : le rapport final peut conserver une apparence parfaitement normale.
Un tableau bien présenté, avec des graphiques cohérents en apparence, ne garantit pas que les informations correspondent au bon périmètre.
La difficulté devient encore plus grande lorsque plusieurs fichiers circulent :
Reporting_octobre.xlsxReporting_octobre_v2.xlsxReporting_octobre_FINAL.xlsxReporting_octobre_FINAL_corrige.xlsx
Quelle version a été validée ? Laquelle a été envoyée à la direction ? Une correction a-t-elle été intégrée dans tous les documents ?
Un processus automatisé bien conçu peut réduire ces ambiguïtés en organisant une production centralisée, des versions identifiables et des règles communes de publication.
Il ne supprime pas nécessairement les fichiers, mais il clarifie leur rôle.
Automatiser commence par stabiliser les règles métier
Avant de choisir un outil, une organisation doit comprendre comment son reporting est réellement produit.
Une responsable explique, par exemple : « Dans cet export, je supprime toujours certaines lignes parce qu’elles correspondent à des opérations annulées. »
Cette manipulation peut être parfaitement justifiée.
Mais si elle n’existe que dans la mémoire de la personne qui prépare le rapport, elle constitue une dépendance.
L’automatisation oblige à expliciter ce type de connaissance.
Quelles sources utiliser ? Quelles opérations exclure ? Quelle période retenir ? Comment calculer les indicateurs ? Quelles anomalies doivent bloquer la publication ? Qui valide le résultat ?
Les réponses deviennent des règles documentées plutôt que des habitudes individuelles.
C’est également le moment de remettre en question certaines étapes. Un indicateur qui n’est jamais consulté mérite-t-il encore d’être calculé ? Deux fichiers apportent-ils réellement des informations complémentaires ? Une correction récurrente ne devrait-elle pas être réalisée directement dans le système d’origine ?
La bonne séquence n’est pas de reproduire mécaniquement toutes les manipulations existantes.
Elle consiste à comprendre, simplifier, standardiser, puis automatiser.
Automatiser un processus inutilement compliqué revient simplement à reproduire sa complexité plus régulièrement.
Du fichier manuel au pipeline de données
En Data Engineering, un pipeline de données désigne une chaîne organisée de traitements permettant de transporter et préparer les informations depuis leurs sources jusqu’à leur destination analytique.
Cette chaîne peut intégrer plusieurs opérations : extraction, transformation, contrôle qualité, consolidation, calcul des indicateurs et actualisation du rapport.
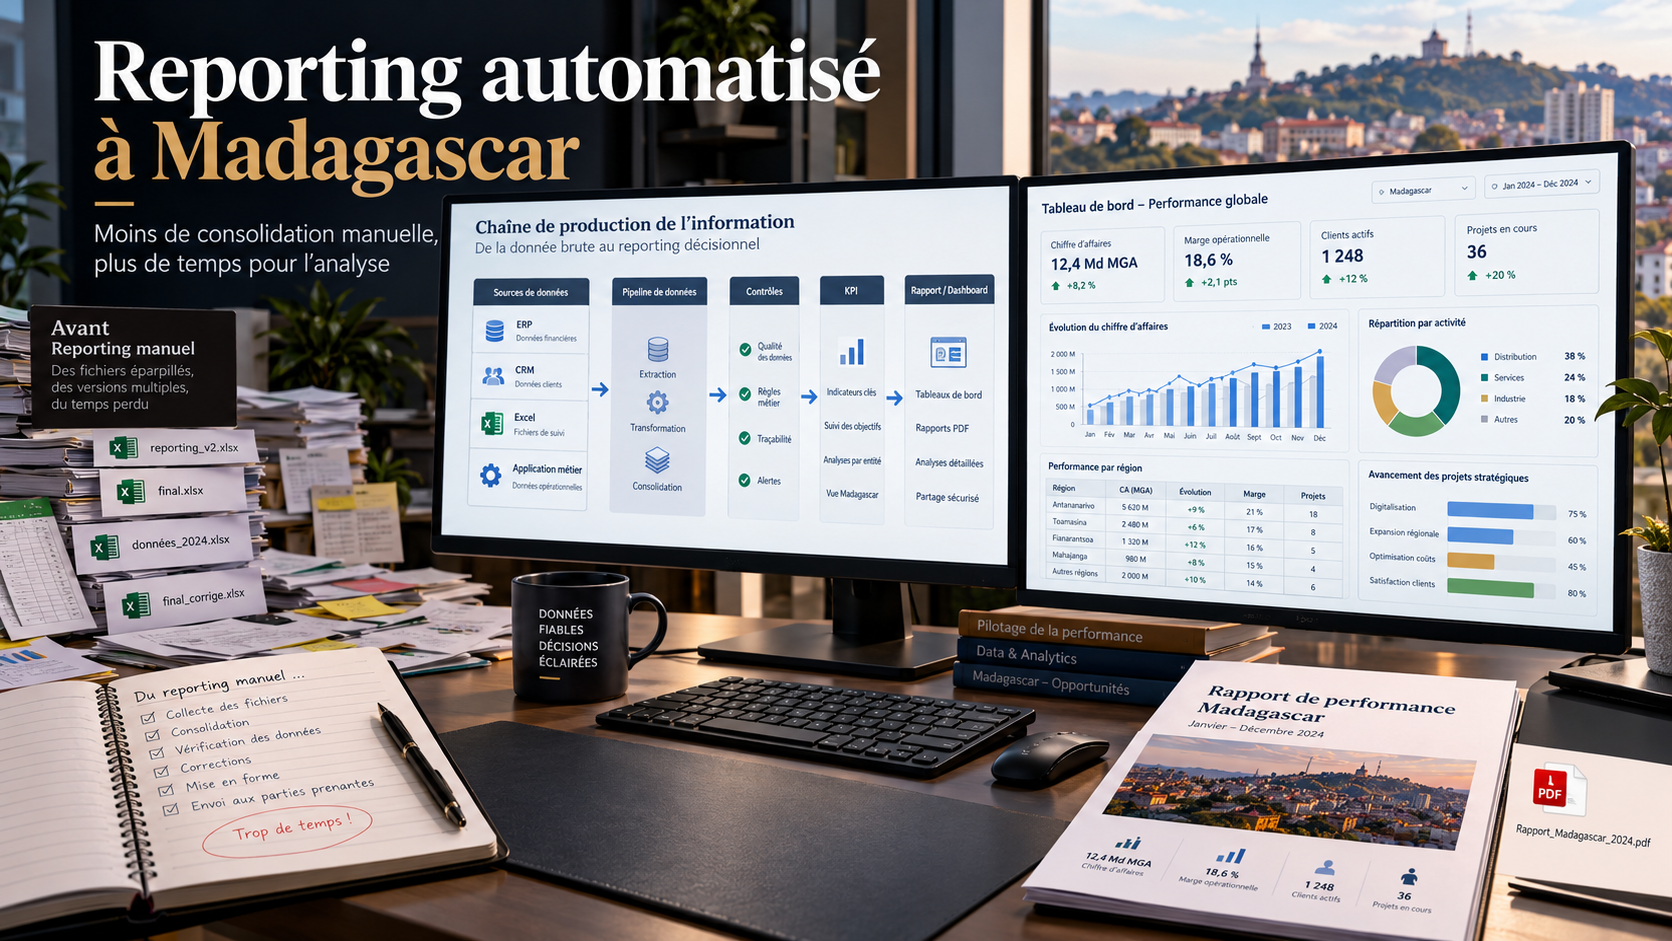
La comparaison entre les deux approches permet de comprendre ce qui change.
Avant : une reconstruction manuelle à chaque échéance
ERP / fichiers sources
↓
Exports Excel
↓
Copier-coller et rapprochements
↓
Formules et corrections
↓
Graphiques et présentation
↓
PDF et envoi
Après : une chaîne reproductible et contrôlée
ERP | CRM | Excel | Application
↓
Collecte et pipeline automatisé
↓
Transformations et contrôles
↓
Modèle de données et KPI
↓
Rapport / dashboard / PDF
↓
Contrôle métier, analyse et décision
Le changement essentiel ne concerne pas uniquement la visualisation.
L’objectif est d’automatiser les opérations répétitives qui précèdent la restitution, et non de remplacer une présentation PowerPoint par un graphique interactif.
Techniquement, ces traitements peuvent suivre une logique ETL — extraction, transformation puis chargement — ou ELT, dans laquelle les données sont d’abord chargées dans un environnement cible avant d’être transformées.
Ces approches sont notamment décrites dans la documentation professionnelle d’IBM sur les différences entre ETL et ELT.
Le choix dépend de l’architecture, des volumes et des usages. Une PME n’a pas besoin de maîtriser ces acronymes pour commencer à automatiser son reporting.
La réflexion sur la consolidation des sources s’inscrit plus largement dans une approche de Data et pilotage décisionnel à Madagascar, qui relie les données opérationnelles aux indicateurs et aux décisions.
Plusieurs niveaux d’automatisation, sans obligation de tout transformer
Un projet de reporting automatisé peut avancer progressivement.
| Niveau | Ce qui peut être automatisé |
|---|---|
| 1. Collecte | Récupération des fichiers ou connexion aux sources |
| 2. Transformation | Formats, renommages, nettoyages et calculs |
| 3. Consolidation | Rapprochement de plusieurs sources |
| 4. Actualisation | Mise à jour planifiée des données et rapports |
| 5. Diffusion | Publication ou transmission des restitutions |
| 6. Contrôles | Vérifications, alertes et détection d'anomalies |
Une organisation peut commencer par automatiser la récupération quotidienne d’un fichier CSV, puis stabiliser les transformations et intégrer progressivement d’autres sources.
Les API, interfaces permettant à des systèmes d’échanger des données structurées, ne sont pas indispensables dans tous les projets.
Un connecteur peut faciliter l’accès à un ERP ou à une base de données. Un fichier Excel déposé régulièrement dans un répertoire contrôlé peut également constituer une source automatisable, si sa structure et sa disponibilité sont suffisamment fiables.
Il faut néanmoins distinguer deux objectifs.
L’intégration de systèmes à Madagascar vise notamment à faire communiquer les applications opérationnelles pour éviter les doubles saisies et assurer la continuité des processus.
L’automatisation du reporting analytique exploite ces informations pour construire des indicateurs cohérents et des restitutions périodiques.
Les deux démarches se complètent, mais ne répondent pas exactement au même besoin.
Automatiser les données ne garantit pas leur exactitude
Une automatisation peut fonctionner parfaitement sur le plan technique et produire un résultat incorrect.
Une nouvelle catégorie apparaît dans l’ERP sans être prise en compte dans le modèle. Une source change de structure. Une jointure entre deux tables multiplie accidentellement certaines lignes. Une application ne transmet plus un champ attendu.
Le traitement peut alors se terminer sans erreur informatique apparente.
C’est pourquoi les contrôles constituent une partie intégrante du pipeline.
Ils peuvent porter sur le nombre d’enregistrements, les totaux, les doublons, les valeurs manquantes, les dates, les variations inhabituelles ou la correspondance entre les données reçues et les données effectivement intégrées.
Cette dernière vérification, appelée réconciliation, permet notamment de comparer les résultats du reporting aux sources de référence.
Il faut aussi distinguer une anomalie certaine d’un écart simplement inhabituel. Une augmentation soudaine des ventes n’est pas nécessairement une erreur : elle peut correspondre à une commande exceptionnelle. Le contrôle automatique doit signaler la situation, sans systématiquement décider à la place du responsable.
Automatiser une mauvaise donnée ne la corrige pas
Une facture incorrectement enregistrée dans l’ERP reste incorrecte lorsqu’elle est transmise automatiquement au reporting.
L’automatisation peut même propager plus rapidement une erreur à plusieurs rapports.
C’est pourquoi la qualité des données à Madagascar doit être considérée comme une condition de fiabilité, et non comme une opération de nettoyage facultative.
La chaîne attendue comprend donc des contrôles avant la restitution et, selon les enjeux, une validation métier avant publication.
Traçabilité et reproductibilité : pouvoir expliquer chaque chiffre
Dans un processus manuel, une correction ponctuelle peut disparaître avec le fichier ou la personne qui l’a réalisée.
Dans un processus automatisé correctement documenté, les transformations sont explicites et peuvent être reproduites.
Un chiffre d’affaires devrait pouvoir être relié à ses factures sources, à la période retenue, aux exclusions appliquées et à la formule utilisée.
Cette capacité à retracer le parcours de la donnée est appelée data lineage, ou traçabilité des données. Elle facilite les audits, les investigations et la maintenance.
Un autre principe est essentiel : à données et règles identiques, une nouvelle exécution doit fournir le même résultat. Elle ne devrait pas ajouter une deuxième fois les mêmes transactions ni modifier les chiffres selon l’ordre d’ouverture des fichiers.
Cette reproductibilité suppose de gérer correctement les identifiants, les périodes, les reprises de traitement et les versions de règles.
Un KPI, une définition commune
Prenons le chiffre d’affaires net.
Le service commercial, la finance et la direction peuvent tous utiliser cet indicateur. Mais si chaque rapport applique sa propre formule, les résultats risquent de diverger : traitement différent des avoirs, des taxes, des annulations ou des dates de comptabilisation.
Un modèle de données partagé permet de centraliser les relations et les règles de calcul. On parle également de modèle sémantique lorsqu'une couche organise les données et leurs définitions métier pour les rendre réutilisables dans plusieurs rapports.
Cette approche évite de recalculer indépendamment la même logique dans chaque fichier.
Elle permet aussi de faire évoluer les règles de manière maîtrisée, sans figer définitivement les indicateurs.
Faut-il construire un Data Warehouse pour automatiser ses rapports ?
Pas nécessairement.
Lorsqu’un rapport utilise une seule source bien structurée, une connexion entre l’ERP et l’outil de Business Intelligence peut suffire.
Lorsque plusieurs applications alimentent de nombreux reportings, une couche analytique intermédiaire devient parfois pertinente.
Un Data Warehouse, ou entrepôt de données, permet de conserver des informations structurées, de les historiser et de les réutiliser pour différents usages.
Cette architecture évite notamment de multiplier les traitements identiques ou les interrogations lourdes sur les systèmes opérationnels.
Mais elle apporte aussi des responsabilités supplémentaires : maintenance, sécurité, supervision et évolution des modèles.
Le bon choix ne dépend donc pas d’une préférence technologique. Il dépend du nombre de sources, des règles métier, de la fréquence des traitements et des besoins réels.
Quelle fréquence d’actualisation choisir ?
L’automatisation ne suppose pas de disposer de données actualisées en permanence.
Un reporting financier mensuel peut être préparé après la clôture. Un suivi commercial peut être actualisé quotidiennement. Un tableau de stock critique peut nécessiter une fréquence plus élevée.
Pour un comité stratégique trimestriel, recalculer tous les indicateurs plusieurs fois par heure n’apporte pas nécessairement une valeur supplémentaire.
En Data Engineering, plusieurs modes d’exécution existent.
Le traitement batch réalise des opérations par lots, à intervalles planifiés : chaque nuit, chaque vendredi ou à la clôture mensuelle.
Un traitement événementiel démarre lorsqu’une condition survient, par exemple lorsqu’un fichier est déposé.
Le temps réel ou quasi temps réel repose sur des mises à jour plus continues, adaptées à certains besoins opérationnels.
L’orchestration organise l’enchaînement de ces opérations, leurs dépendances et leurs éventuelles reprises.
Le critère déterminant reste la décision à prendre, pas la fréquence maximale techniquement possible.
Un traitement automatisé doit aussi signaler ses échecs
Un rapport qui s’affiche ne prouve pas nécessairement que ses données ont été actualisées.
Un processus fiable doit donc pouvoir conserver des journaux d’exécution, ou logs, indiquer le statut des traitements, signaler les erreurs et afficher la date de dernière actualisation réussie.
Le monitoring, ou supervision, permet de vérifier que le système continue à fonctionner dans les conditions attendues.
Microsoft documente notamment ces mécanismes de planification, d’historique des actualisations et de notification des échecs dans Power BI.
Pour un rapport important, une donnée ancienne doit être identifiable. Une publication automatique peut même être suspendue lorsque certains contrôles critiques échouent.
C’est une question de confiance autant que de technique.
Trois situations métier où l’automatisation change le travail quotidien
Reporting financier : consacrer la clôture à expliquer les écarts
Une direction financière rassemble les factures et avoirs de l’ERP, les encaissements issus des données bancaires, les budgets Excel et les informations par centre de coûts.
Manuellement, elle effectue chaque mois les mêmes rapprochements, vérifie les écarts et reconstruit les tableaux.
Une automatisation peut collecter les sources disponibles, appliquer des règles de correspondance, calculer les indicateurs et préparer un rapport soumis à validation.
Les rapprochements sensibles et les corrections comptables continuent de relever des responsables concernés.
L’équipe dispose cependant de davantage de temps pour analyser les créances, expliquer les variations budgétaires et préparer les arbitrages.
Reporting commercial : rapprocher CRM, commandes et facturation
Le CRM présente les prospects, les opportunités et les prévisions commerciales.
L’ERP enregistre les commandes, factures et éventuellement les encaissements.
Lorsque ces informations restent séparées, préparer une réunion commerciale suppose souvent plusieurs exports et rapprochements.
Un dispositif automatisé peut associer les opportunités aux commandes, comparer le chiffre d’affaires commandé, facturé et encaissé, puis mesurer les écarts aux objectifs.
Encore faut-il définir les identifiants communs, les règles de rapprochement et le traitement des cas particuliers.
Cette logique prolonge les enjeux de gestion commerciale et facturation à Madagascar : la continuité des informations permet un pilotage plus cohérent de l’activité.
Stock et logistique : suivre les mouvements plutôt que reconstruire les états
Dans une entreprise de distribution, les achats, ventes, mouvements de stock, réceptions et inventaires peuvent être enregistrés dans plusieurs outils.
Un reporting manuel exige régulièrement de reconstituer les quantités disponibles et les écarts entre les données.
L’automatisation peut faciliter le calcul des ruptures, de la couverture, de la rotation ou des commandes attendues.
Elle reste dépendante de la fiabilité des mouvements enregistrés et des inventaires physiques.
Les organisations qui travaillent sur la gestion de stock à Madagascar ont donc intérêt à distinguer l'amélioration de la saisie opérationnelle et l'automatisation des indicateurs qui en découlent.
Le même raisonnement s’applique aux ONG et aux organisations multisites : les remontées d’activité peuvent être consolidées automatiquement, tandis que les responsables conservent la validation des résultats transmis par les équipes terrain.
Un rapport automatisé peut rester un PDF
L’automatisation ne dicte pas le format de restitution.
Un PDF demeure pertinent pour un comité de direction, une archive officielle ou un compte rendu périodique.
Un tableau de bord interactif facilite les filtres, la consultation régulière et l’exploration des détails.
Un e-mail synthétique peut suffire pour communiquer quelques indicateurs ou alerter sur une situation particulière.
Un export institutionnel peut devoir respecter une structure imposée.
La question n’est donc pas de remplacer tous les documents par des dashboards. Elle est de produire la bonne restitution à partir de données maîtrisées, dans le format adapté aux utilisateurs.
La confidentialité reste également essentielle : authentification, droits par rôle, restriction des périmètres et diffusion contrôlée doivent être prévus dès la conception.
Tous les reportings ne méritent pas d’être automatisés
Un rapport exceptionnel, très exploratoire ou rarement utilisé ne constitue pas nécessairement un bon candidat.
L’automatisation implique un coût de conception, de développement, de test et de maintenance.
À l’inverse, un rapport fréquent, stable, utilisé par plusieurs personnes et nécessitant de nombreux rapprochements présente souvent un intérêt plus évident.
Votre reporting est-il un bon candidat à l’automatisation ?
Quelques questions permettent de faire un premier diagnostic :
- Est-il produit régulièrement, avec des sources relativement identiques ?
- Les mêmes exports, nettoyages et copier-coller sont-ils répétés ?
- Plusieurs fichiers ou applications doivent-ils être rapprochés ?
- Les règles de calcul sont-elles suffisamment définies ?
- Le processus dépend-il fortement d'une seule personne ?
- Les erreurs ou différences de versions sont-elles difficiles à identifier ?
- Le rapport est-il réellement utilisé pour prendre des décisions ?
Des réponses positives répétées justifient d'examiner les possibilités d’automatisation, sans constituer à elles seules une justification économique.
Comment commencer un projet de reporting automatisé à Madagascar ?
Une démarche pragmatique consiste à partir d’un seul reporting réellement utilisé, plutôt que de chercher immédiatement à automatiser toute l’information de l’entreprise.
Le travail peut suivre plusieurs étapes :
- Observer le processus existant. Identifier les intervenants, les sources, les manipulations et les délais.
- Clarifier les besoins. Supprimer les indicateurs inutiles et préciser les décisions attendues.
- Formaliser les règles. Définir les KPI, périodes, exclusions, correspondances et validations.
- Évaluer les sources. Vérifier leur accessibilité, leur qualité et leur fréquence de mise à jour.
- Simplifier puis automatiser. Construire progressivement la collecte, les transformations et la consolidation.
- Sécuriser la production. Intégrer les contrôles, les journaux, les alertes et les droits d’accès.
- Tester et maintenir. Comparer les résultats au processus actuel, valider avec les utilisateurs et documenter les évolutions.
Le déploiement peut commencer par une automatisation partielle et conserver temporairement certains contrôles manuels.
La réussite doit ensuite être évaluée au-delà du temps gagné : délai de disponibilité, réduction des erreurs de manipulation, reproductibilité, traçabilité, consultation effective des rapports et capacité à identifier plus rapidement les situations nécessitant une action.
Un reporting parfaitement automatisé mais jamais utilisé reste un mauvais investissement.
FAQ : comprendre le reporting automatisé
Qu’est-ce qu’un reporting automatisé ?
Un reporting automatisé est un processus dans lequel la collecte, la préparation, la consolidation, le calcul des indicateurs et éventuellement la diffusion des rapports sont réalisés avec moins d’interventions manuelles. Il peut fonctionner quotidiennement, hebdomadairement ou mensuellement, selon les besoins.
Peut-on automatiser un reporting Excel ?
Oui. Excel peut rester une source de données, un outil de contrôle ou un format de restitution. Des connexions et traitements reproductibles permettent d'automatiser une partie des opérations auparavant réalisées manuellement. L’essentiel est de stabiliser les règles et les sources.
Faut-il utiliser Power BI pour automatiser ses rapports ?
Non. Power BI peut contribuer à la transformation, à la modélisation, à l’actualisation et à la visualisation des données. Mais l’automatisation dépend aussi des systèmes sources, des flux, des contrôles et de l’architecture. D’autres outils et approches peuvent être adaptés.
Quelle différence entre reporting automatisé et tableau de bord ?
Le reporting automatisé concerne principalement le processus de production et de mise à disposition des informations. Le tableau de bord est une forme de restitution, généralement conçue pour consulter et explorer des indicateurs. Un reporting automatisé peut produire un tableau de bord, un PDF ou un autre document.
Faut-il automatiser tous les reportings ?
Non. Un rapport ponctuel, rarement utilisé ou dont les règles évoluent constamment peut rester manuel. L’automatisation devient surtout pertinente lorsque les traitements sont répétitifs, suffisamment stables et importants pour les utilisateurs.
Un reporting automatisé peut-il contenir des erreurs ?
Oui. Une source incorrecte, une mauvaise règle de calcul, un doublon ou un traitement incomplet peuvent produire des résultats erronés. L’automatisation doit donc être accompagnée de contrôles qualité, d’une supervision et, lorsque nécessaire, d’une validation métier.
Du temps consacré à produire les chiffres au temps consacré à les comprendre
Revenons à cette responsable administrative qui, chaque fin de mois, reconstitue son reporting à partir d’exports, de fichiers Excel et de corrections successives.
Son travail ne disparaît pas nécessairement avec l’automatisation. Il change de nature.
Lorsque les sources sont identifiées, les règles documentées, les traitements reproductibles et les contrôles intégrés, elle n’a plus besoin de reconstruire manuellement chaque étape du processus.
Elle peut vérifier les résultats, examiner les anomalies, expliquer les écarts et préparer les décisions avec les autres responsables.
L’effort humain se déplace progressivement de la préparation répétitive vers le contrôle et l’analyse.
Cette évolution ne dépend pas uniquement d'un logiciel. Elle suppose une compréhension des processus métier, de la qualité des données, des règles de calcul et des usages décisionnels.
C’est dans cette perspective que s’inscrit l’approche de Data et pilotage décisionnel à Madagascar de HEMERA media & conseil : relier les sources, structurer les indicateurs, automatiser les flux pertinents et construire des restitutions adaptées aux besoins des organisations.
Car l’objectif final n’est pas simplement de produire le même rapport plus rapidement.
Il est d’éviter de refaire chaque mois les mêmes manipulations pour consacrer davantage de temps à comprendre ce que les chiffres racontent — et à décider ce qu’il convient d’en faire.