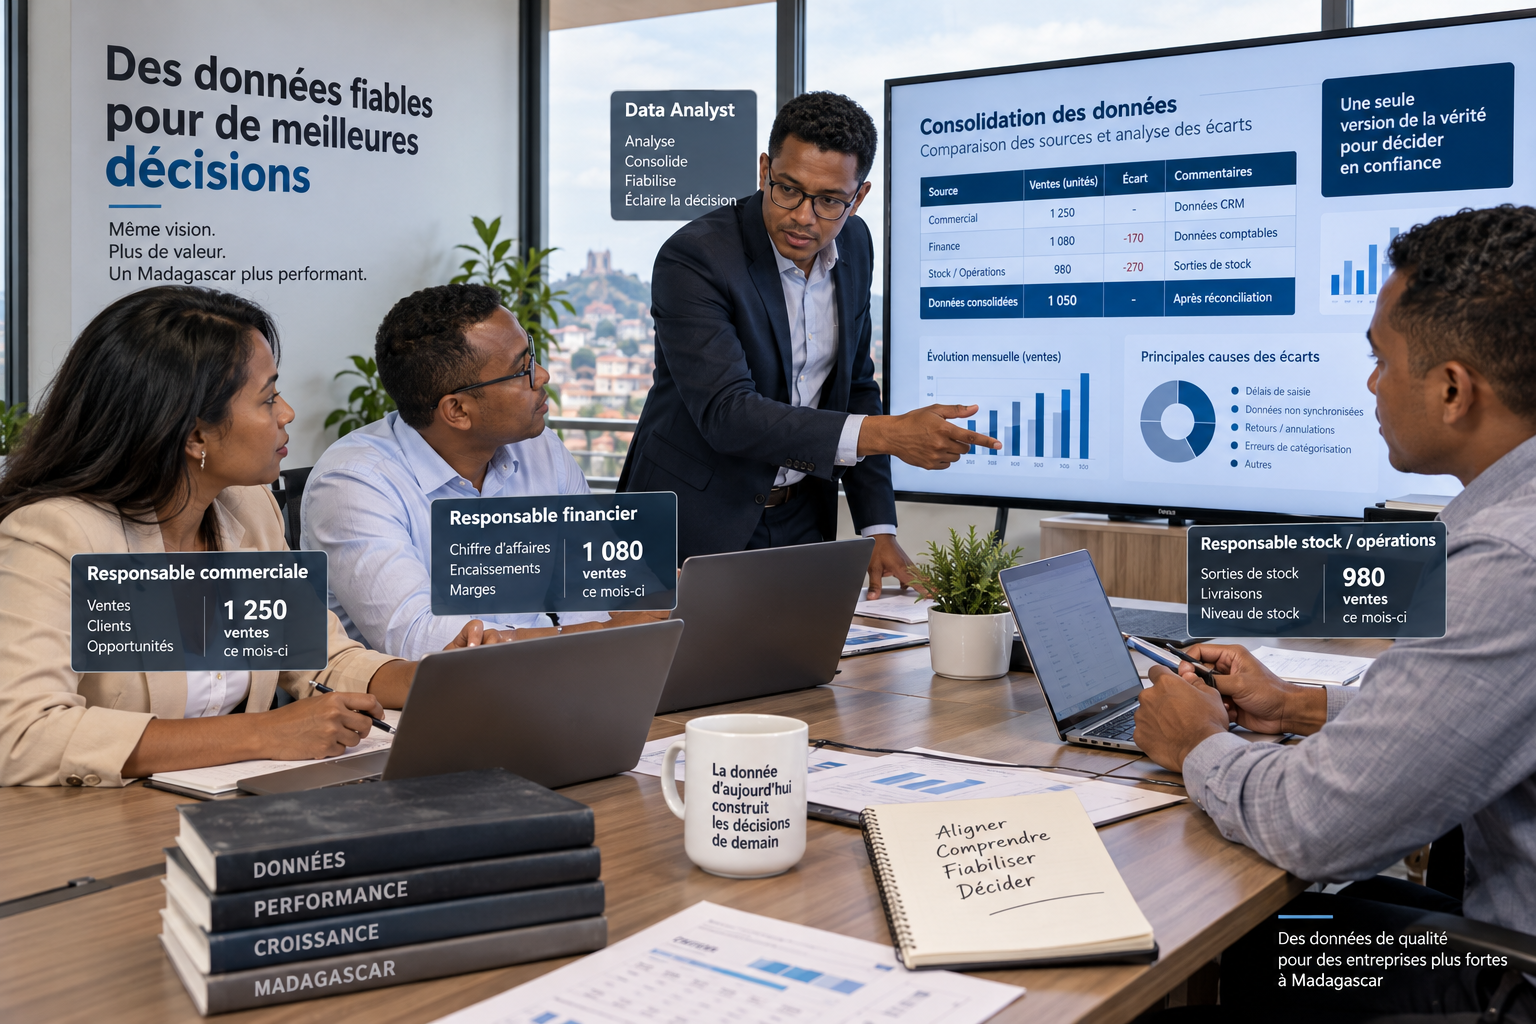
Une direction demande combien l’entreprise compte de clients actifs.
Le CRM affiche 1 842 clients. La comptabilité en dénombre 1 615. Le fichier utilisé par l’équipe commerciale en compte 1 973.
Quel chiffre est correct ?
La première réaction consiste souvent à chercher une erreur de calcul ou un problème informatique. Pourtant, les trois résultats peuvent avoir été calculés correctement. Le désaccord peut venir d’ailleurs : un service considère comme actif tout client ayant commandé au cours des douze derniers mois, un autre conserve comme actifs les comptes non clôturés, tandis que le CRM s’appuie sur un statut renseigné manuellement.
À cela peuvent s’ajouter des clients enregistrés plusieurs fois, des fiches anciennes, des informations incomplètes ou des mises à jour effectuées à des dates différentes.
Le problème n’est alors plus le calcul. Il est dans la donnée elle-même et dans les règles qui permettent de l’interpréter.
L’article précédent consacré à la Data à Madagascar montrait déjà pourquoi collecter des données ne suffit plus pour bien décider. Entre la donnée brute et la décision existe une étape déterminante : la fiabilité.
Car un tableau de bord peut être techniquement excellent, automatisé, agréable à consulter et néanmoins donner une représentation trompeuse de l’activité.
Un beau dashboard ne compense pas une donnée source défaillante.
Quand plusieurs chiffres décrivent la même réalité
La situation des « clients actifs » n’a rien d’exceptionnel.
Dans une entreprise de distribution, le stock disponible affiché dans l’ERP peut différer du stock constaté physiquement dans l’entrepôt. Dans une société de services, le montant des créances suivi par l’équipe commerciale peut ne pas correspondre exactement à celui de la comptabilité. Dans une ONG, deux fichiers peuvent donner un nombre différent de bénéficiaires suivis. Sur un projet multisite, l’avancement communiqué par les équipes terrain peut différer du reporting consolidé au siège.
Ces exemples sont illustratifs. Ils peuvent concerner des organisations à Madagascar comme ailleurs dès lors que plusieurs outils, processus et équipes produisent ou manipulent les mêmes informations.
La question importante n’est donc pas seulement : « Qui a le bon chiffre ? »
Il faut aussi demander : de quelle source vient-il ? À quelle date a-t-il été extrait ? Quelle règle a été utilisée ? Quelles informations manquent ? Les mêmes objets ont-ils été comptés plusieurs fois ? Et surtout : les différents services donnent-ils le même sens aux mots utilisés ?
C’est à ce niveau qu’intervient la qualité des données.
Une donnée de qualité n’est pas simplement une donnée sans faute
La qualité des données recouvre plusieurs dimensions. IBM retient notamment l’exactitude, la complétude, la validité, la cohérence, l’unicité, l’actualité et l’adéquation à l’usage. Les normes de la famille ISO 8000 traitent également de différents aspects de la qualité des données et rappellent que celle-ci ne se résume pas à une simple question de format technique. (ibm.com)
L’exactitude concerne la correspondance avec la réalité. Si une facture indique 850 000 ariary alors que le montant réel est 580 000 ariary, la donnée est incorrecte.
La complétude pose une autre question : toutes les informations nécessaires sont-elles présentes ? Une base clients peut contenir des noms exacts tout en étant difficilement exploitable si une grande partie des régions, secteurs d’activité ou coordonnées utiles n’est jamais renseignée.
La cohérence concerne la compatibilité des informations entre elles. Un client peut, par exemple, être classé comme « clôturé » dans un système et comme « actif » dans un autre.
La validité vérifie le respect des règles attendues : formats de date, plages de valeurs, codes produits, catégories autorisées ou règles métier.
L’unicité vise notamment les doublons.
L’actualité demande si la donnée est suffisamment récente.
Enfin, l’adéquation à l’usage oblige à poser une question souvent oubliée : la donnée est-elle assez bonne pour la décision que nous voulons prendre ?
Une adresse client datant de trois ans peut encore être correcte. Elle peut aussi être trop ancienne pour préparer une livraison aujourd’hui. Un inventaire réalisé vendredi peut suffire pour un reporting mensuel, mais être insuffisant pour confirmer lundi matin la disponibilité immédiate d’un produit très demandé.
Il n’existe donc pas nécessairement une donnée « parfaite » dans l’absolu. L’objectif professionnel consiste à disposer d’informations suffisamment exactes, complètes, cohérentes et récentes pour l’usage concerné.
Les doublons : quand une même réalité existe plusieurs fois
Les doublons constituent l’un des problèmes les plus visibles, mais aussi l’un des plus trompeurs.
Un même client peut apparaître sous différentes formes :
« Société ABC »
« ABC SARL »
« ABC S.A.R.L. »
« ABC Madagascar »
Ou encore sous deux fiches identiques, créées à quelques mois d’intervalle par deux collaborateurs qui ignoraient l’existence de la première.
Les numéros de téléphone peuvent également être enregistrés avec ou sans indicatif international. Une entreprise peut utiliser son nom commercial dans le CRM et sa raison sociale complète en comptabilité. Un même produit peut avoir deux références parce qu’il a été recréé lors d’une migration.
À première vue, ces différences peuvent sembler mineures.
Pourtant, si chaque fiche est comptée comme un client distinct, le nombre de clients actifs augmente artificiellement. L’historique commercial se retrouve fragmenté. Les achats effectués par une même entreprise apparaissent répartis entre plusieurs comptes. Une campagne de communication peut contacter deux fois la même personne. Une analyse de fidélisation peut considérer comme nouveaux des clients déjà connus.
Dans le stock, un produit enregistré sous deux références peut compliquer la consolidation des quantités disponibles et des mouvements.
Les outils informatiques peuvent évidemment aider à repérer ou supprimer certains doublons. Power Query, utilisé notamment avec Power BI, permet par exemple de rechercher et de supprimer des lignes dupliquées selon des colonnes déterminées. Microsoft souligne toutefois que ces traitements s’appuient sur des critères définis : l’outil compare des valeurs, il ne connaît pas spontanément la réalité métier située derrière deux fiches. (learn.microsoft.com)
Décider que « ABC SARL » et « ABC Madagascar » représentent réellement la même organisation peut nécessiter d’examiner un identifiant fiscal, une adresse, un téléphone, un contrat ou une règle métier.
La déduplication n’est donc pas seulement une opération technique. C’est parfois une décision métier.
Les données manquantes : ce qui n’est pas renseigné compte aussi
Une donnée absente semble moins dangereuse qu’une donnée fausse. Elle peut pourtant modifier profondément un indicateur.
Imaginons un reporting commercial dans lequel le responsable de compte n’est renseigné que pour 80 % des opportunités. Le chiffre d’affaires global peut être exact, mais une comparaison entre commerciaux reposera seulement sur les dossiers correctement affectés.
Même problème avec une date de paiement absente. Un calcul de délai moyen d’encaissement peut ignorer certaines factures ou les traiter différemment selon la règle utilisée.
Dans un stock, une catégorie produit manquante peut exclure certains articles d’une analyse par famille. Dans une organisation multisite, l’absence de région ou d’agence peut rendre une partie des opérations invisible lors d’une comparaison géographique.
Pour un programme d’ONG, un champ incomplet concernant le statut d’un dossier ou d’un bénéficiaire peut modifier les agrégations utilisées dans un reporting de suivi.
Le danger vient du fait que le résultat final conserve souvent une apparence de précision.
Un tableau de bord peut afficher « 37,4 % » avec deux décimales. Cela ne signifie pas que le taux représente correctement toute la population attendue.
Avant d’interpréter un indicateur, il faut donc aussi savoir quelle proportion des données nécessaires est effectivement renseignée.
Erreurs de saisie : de petites anomalies peuvent parcourir toute la chaîne
Une virgule déplacée, un zéro supplémentaire, une mauvaise unité, une date au mauvais format, une référence produit erronée ou une catégorie mal sélectionnée peuvent sembler être des incidents locaux.
Ils ne le restent pas toujours.
Un montant saisi dix fois trop élevé peut modifier une moyenne. Une date enregistrée avec le mauvais mois peut déplacer une vente vers une autre période. Des kilogrammes saisis à la place de tonnes peuvent perturber un indicateur logistique. Une opération terrain rattachée au mauvais projet peut se retrouver consolidée dans le mauvais reporting.
Réduire ces problèmes à « l’utilisateur s’est trompé » serait cependant trop simple.
La qualité de la saisie dépend aussi de la conception du système.
Un formulaire comportant vingt champs libres laisse davantage de place aux variantes qu’un formulaire utilisant des listes contrôlées. Une date saisie manuellement présente plus de risques qu’un calendrier imposant le format attendu. Une référence produit recopiée à chaque opération est plus fragile qu’une sélection dans un référentiel existant.
Des champs obligatoires, des listes de valeurs autorisées, des contrôles de formats, des validations automatiques, des droits adaptés et certaines règles de cohérence permettent de réduire une partie de ces erreurs dès leur création.
Autrement dit, améliorer la donnée revient souvent à améliorer le processus qui la produit.
Le problème le plus discret : lorsque les mots n’ont pas la même définition
Les erreurs visibles sont généralement les plus faciles à détecter.
Les différences de définition sont plus dangereuses parce que les données peuvent parfaitement respecter les règles de chaque système.
Reprenons le terme client actif.
Pour le service commercial, il peut désigner un client ayant acheté au cours des douze derniers mois.
Pour la comptabilité, il peut s’agir d’un compte client qui n’a pas été clôturé.
Pour le CRM, la règle peut simplement dépendre du champ « statut = actif ».
Chaque service applique alors correctement sa définition et produit pourtant un résultat différent.
La même difficulté apparaît avec le chiffre d’affaires.
Parle-t-on des commandes enregistrées ? Des factures émises ? Des factures effectivement payées ? Des montants hors taxes ou toutes taxes comprises ? Les avoirs sont-ils retranchés ? Les commandes annulées restent-elles incluses ?
Aucun logiciel de Business Intelligence ne peut décider seul quelle définition correspond au besoin de l’entreprise.
Avant le calcul vient donc la règle métier.
Les indicateurs importants doivent progressivement disposer d’une définition comprise par leurs utilisateurs : périmètre, mode de calcul, source, fréquence de mise à jour et, lorsque cela est nécessaire, personne ou fonction responsable de cette définition.
C’est ici que commence à apparaître la question plus large de la gouvernance des données. Elle mérite un traitement spécifique. Mais pour la qualité des données, un principe suffit déjà : un indicateur partagé nécessite un langage partagé.
Une donnée correcte peut devenir trompeuse avec le temps
Une autre dimension est souvent sous-estimée : la fraîcheur.
Supposons qu’un fichier de stock ait été parfaitement exact vendredi soir.
Si plusieurs ventes et réceptions ont eu lieu pendant le week-end et que le fichier n’est actualisé que le mardi, il n’est pas nécessairement « faux ». Il représente simplement une situation ancienne.
Le problème apparaît lorsqu’il est utilisé pour prendre une décision qui exige une vision plus récente.
Même logique pour des coordonnées clients, un statut d’opportunité commerciale, l’avancement d’un chantier, la situation d’une facture ou un reporting d’interventions terrain.
Il serait cependant excessif d’en conclure que toute information doit être disponible en temps réel.
Une direction peut parfaitement piloter certains indicateurs mensuellement. Un responsable logistique aura éventuellement besoin de données quotidiennes, voire plus fréquentes. Un suivi de trésorerie peut nécessiter une autre périodicité.
La vraie question n’est donc pas : « Pouvons-nous obtenir cette information en temps réel ? »
Elle est : « À quelle fréquence doit-elle être actualisée pour la décision que nous voulons prendre ? »
Comment une mauvaise donnée devient une mauvaise décision
Les problèmes de qualité paraissent parfois techniques jusqu’à ce que l’on observe leur propagation.
Prenons un exemple fictif de gestion de stock.
Le stock informatique surestime la quantité disponible. Le commercial accepte une commande en pensant pouvoir la servir. Lors de la préparation, l’entrepôt constate la rupture réelle. La livraison est retardée, le client doit être prévenu et un approvisionnement urgent peut devenir nécessaire.
L’erreur initiale concernait une quantité. Sa conséquence concerne l’activité.
Dans le domaine commercial, des doublons peuvent gonfler le nombre de clients actifs. Le taux de fidélisation calculé à partir de cette base devient alors trompeur. La direction peut en conclure que le portefeuille évolue mieux — ou moins bien — qu’en réalité, puis concentrer les efforts commerciaux sur une mauvaise priorité.
En finance, des paiements non rapprochés avec leurs factures peuvent conduire à surestimer les créances encore ouvertes. À l’inverse, certains encaissements manquants peuvent donner une lecture trop optimiste ou trop pessimiste de la trésorerie attendue.
La donnée n’a donc pas besoin d’être manifestement « fausse » pour créer un risque.
Elle peut être correcte mais trop ancienne. Exacte mais incomplète. Valide mais rattachée au mauvais périmètre. Correctement calculée mais fondée sur une définition différente de celle attendue par le décideur.
Pourquoi Power BI ne peut pas réparer seul de mauvaises données
Power BI et les outils de Business Intelligence peuvent jouer un rôle important dans l’amélioration de la qualité.
Power Query propose notamment des fonctions de profilage permettant d’examiner la qualité, la distribution ou le profil des colonnes. Il peut signaler des valeurs vides ou en erreur, transformer des formats, filtrer des données, appliquer des règles et traiter certains doublons. (learn.microsoft.com)
Lorsqu’un dispositif est bien conçu, la BI peut également rapprocher plusieurs sources, automatiser des contrôles et faire apparaître des incohérences qui seraient difficiles à repérer manuellement.
Mais elle rencontre rapidement une limite : la compréhension métier.
Power BI ne peut pas deviner pourquoi deux clients portent presque le même nom. Il ne sait pas automatiquement quelle base doit faire référence lorsque deux systèmes donnent des résultats différents. Il ne peut pas déterminer si une facture de 12 millions d’ariary est une erreur de saisie ou une opération exceptionnelle parfaitement légitime.
Il ne peut pas non plus choisir à la place de l’organisation ce que signifie « vente réalisée », « dossier traité », « bénéficiaire actif » ou « projet terminé ».
La BI peut aider à nettoyer, transformer et contrôler les données. Elle ne remplace ni les règles métier ni la responsabilité exercée sur les données sources.
C’est précisément pour cette raison qu’un projet de Data et pilotage décisionnel à Madagascar commence utilement par l’examen des sources, des processus et des indicateurs avant la construction du tableau de bord.
D’où viennent réellement les problèmes de qualité ?
Les causes sont rarement uniques.
Une entreprise peut travailler avec plusieurs fichiers indépendants parce que chaque équipe a progressivement construit son propre outil. Des informations peuvent être ressaisies entre un CRM, un ERP et un logiciel comptable. Deux applications peuvent utiliser des identifiants différents pour les mêmes produits. Une migration ancienne peut avoir conservé des enregistrements en double.
Ailleurs, les catégories ont évolué sans que l’historique soit harmonisé. Certains champs ont été laissés libres. Des règles connues oralement n’ont jamais été documentées. Un système n’est synchronisé qu’une fois par jour alors qu’un autre est actualisé immédiatement.
Lorsque les données opérationnelles proviennent d’ERP, de CRM ou d'applications métier, leur qualité dépend donc étroitement de la manière dont le système d’information est structuré. La réflexion autour des ERP, CRM et de l’intégration des systèmes d’information à Madagascar dépasse ainsi largement la seule installation de logiciels.
La centralisation des données de l’entreprise peut réduire le nombre de versions concurrentes d’une même information. De même, une meilleure intégration de systèmes à Madagascar peut limiter certaines doubles saisies et automatiser la circulation des informations.
Mais connecter les systèmes n’est pas suffisant.
Une automatisation transmet très efficacement des données correctes. Elle peut aussi transmettre très efficacement une erreur.
Plus le système est intégré, plus la qualité des informations qui circulent mérite donc d’être traitée en amont.
Comment commencer sans lancer un gigantesque chantier de nettoyage
Une PME ou une organisation n’a pas nécessairement besoin de commencer par auditer toutes les données accumulées depuis dix ans.
Une approche plus pragmatique consiste à partir d’une décision ou d’un reporting réellement important.
- Choisir un besoin critique. Par exemple : disponibilité des stocks, suivi des créances, activité commerciale, avancement d’un programme ou pilotage des interventions.
- Identifier les indicateurs réellement utilisés. Quels chiffres déclenchent une décision, une alerte ou une action ?
- Remonter jusqu’aux données sources. D’où viennent les montants, dates, statuts, quantités ou catégories qui alimentent ces indicateurs ?
- Identifier les producteurs de la donnée. Quels logiciels, fichiers, interfaces ou personnes créent et modifient l’information ?
- Rechercher les anomalies prioritaires. Doublons, champs vides, valeurs incohérentes, formats variables, données anciennes ou rapprochements impossibles.
- Clarifier les définitions. Que signifie exactement chaque indicateur important ?
- Identifier une source de référence. Lorsque plusieurs systèmes contiennent la même information, lequel fait autorité pour l’usage concerné ?
- Prévenir les erreurs à la saisie. Introduire progressivement des contrôles, listes, règles et validations.
- Corriger d’abord ce qui influence les décisions. Toutes les données historiques ne présentent pas la même valeur.
- Suivre les anomalies dans le temps. La qualité n’est pas un nettoyage exceptionnel, mais un processus continu.
Cette approche évite un piège fréquent : vouloir « nettoyer toute la base » avant même d’avoir identifié les données réellement importantes.
La priorité doit rester l’usage.
Une fiche fournisseur ancienne qui n’est plus utilisée n’a pas nécessairement la même importance qu’une référence produit erronée intervenant chaque jour dans les ventes et les stocks.
De la qualité des données à la confiance dans les chiffres
Le véritable enjeu de la qualité des données n’est pas esthétique.
Il ne s’agit pas de disposer de bases parfaitement rangées pour satisfaire une exigence technique.
Il s’agit de construire progressivement la confiance.
Lorsqu’une réunion de direction commence systématiquement par quinze minutes de discussion pour déterminer quel fichier contient le chiffre correct, une partie de la valeur du reporting est déjà perdue.
Les participants ne discutent pas encore de la situation de l’entreprise. Ils discutent de la fiabilité de l’information utilisée pour la décrire.
À l’inverse, lorsque les définitions sont comprises, que les sources sont identifiées, que les anomalies importantes sont contrôlées et que la fréquence de mise à jour correspond aux besoins, la discussion peut changer de nature.
Elle passe de :
« Quel chiffre est le bon ? »
à :
« Que devons-nous faire à partir de ce chiffre ? »
C’est à ce moment que la donnée devient réellement utile au pilotage.
La qualité ne consiste donc pas à viser une improbable perfection de chaque information. Elle consiste à rendre les données suffisamment fiables, complètes, cohérentes et récentes pour les décisions qu’elles doivent éclairer.
Avant de demander ce que montre un tableau de bord, une organisation doit ainsi pouvoir répondre à une question plus fondamentale : peut-elle avoir confiance dans les données qui l’alimentent ?
C’est également dans cette logique que HEMERA media & conseil aborde la Data et le pilotage décisionnel : comprendre les sources, les processus, les règles métier et la circulation de l’information avant de construire les indicateurs, les automatisations et les tableaux de bord qui serviront à la décision.
FAQ — Qualité des données et pilotage décisionnel
Qu’est-ce que la qualité des données ?
La qualité des données désigne leur capacité à répondre correctement à un usage donné. Elle peut notamment être évaluée selon leur exactitude, leur complétude, leur cohérence, leur validité, leur unicité et leur actualité. Une donnée n’a donc pas besoin d’être parfaite dans l’absolu : elle doit être suffisamment fiable pour la décision ou le processus auquel elle sert.
Pourquoi les doublons faussent-ils les indicateurs ?
Un doublon peut faire apparaître plusieurs fois une même réalité. Deux fiches correspondant au même client peuvent gonfler artificiellement le nombre de clients, fragmenter son historique ou modifier certains taux. Dans un référentiel produit ou fournisseur, les doublons compliquent également les consolidations et les rapprochements.
Power BI peut-il corriger automatiquement les mauvaises données ?
Power BI et Power Query peuvent détecter certaines anomalies, transformer les données, appliquer des règles, repérer des valeurs manquantes ou traiter des doublons selon des critères définis. Ils ne peuvent toutefois pas déterminer seuls quelle donnée correspond à la réalité métier, quelle source doit faire référence ou quelle définition d’un indicateur doit être retenue.
Par où commencer pour améliorer la qualité des données ?
Il est souvent plus efficace de choisir d’abord un reporting ou une décision importante, puis de remonter jusqu’aux données qui l’alimentent. Cette démarche permet de concentrer les efforts sur les anomalies qui ont un véritable impact métier plutôt que d’entreprendre immédiatement le nettoyage de toutes les données disponibles.
Quelle différence entre qualité et gouvernance des données ?
La qualité concerne principalement la fiabilité et l’utilité des données : sont-elles exactes, complètes, cohérentes, valides et suffisamment récentes ? La gouvernance couvre un champ plus large : responsabilités, règles, propriété des données, standards, processus et modalités d’utilisation. La gouvernance permet notamment d’organiser dans la durée les responsabilités nécessaires au maintien de la qualité.